

主题
生成指标:忠实度、正确率,以及用模型当评判(LLM-as-judge)的坑
本章要回答的问题:答案对不对怎么量化?用大模型当裁判靠谱吗,坑在哪?
5.8 的判定是字面/数字匹配,benchmarks/rag/README.md 里写明没有用 LLM-as-judge。这一节补上后半句:如果把评判交给模型,会发生什么;以及在没有人工标签时,裁判分数为什么不能直接当正确率。
先给结论:字符串判定适合当回归哨兵,裁判适合做初筛,两者都不能替代人工校准。 下面的数字会说明,为什么一个看起来 85% 准确的裁判,实际只比「全部判对」的基线高 2 个百分点。
三种「对」不是一回事
| 指标 | 问的问题 | 依据 | 典型失败 |
|---|---|---|---|
| 正确率 | 答案和标准答案一致吗? | 人工标签 / 标准答案 | 措辞不同被判错 |
| 忠实度 | 结论能在资料里找到依据吗? | 检索到的段落 | 忠实,但答非所问 |
| 拒答正确率 | 资料不足时,是否明确拒答? | 拒答题 | 编造或含糊其辞 |
三者会分开。X13 问的是「未采取措施消除隐患」的罚款,模型答成了「未记录/通报」那一档:它忠实于资料里的另一档条款,但不正确。X03 答对了「接到报告应当及时处理」,但漏了标准答案里的第二种情况:它正确了一部分,忠实没有问题。
把忠实度混进正确率,会得到「答得挺全但没依据」和「有依据但答偏」两类完全不同的错误却同一个分数。分开报,才知道下一步该修检索、修提示词,还是修资料。
字符串判定:只适合当哨兵
5.8 的判定是子串 + bigram 覆盖率 ≥0.6 + 数字全包含。在 60 道可答题上:
- 判对 41 道,没有一道误报(精确率 1.00);
- 漏掉 9 道改写(召回率 0.82);
- 与人工标签一致 51/60(85%),Cohen's κ = 0.603。
(实测,见 benchmarks/evaluation/string-baseline.csv;由 labs/06-evaluation/string_baseline.py 从 generation.jsonl 与 generation-audit.csv 复算。)
这个错误结构是单向的:它只会漏,不会冤。对回归测试来说这是好事——今天通过的,明天不会因为改写而误报;但它不能回答「模型答对了多少」,因为它把「换个说法答对」全部记成错。
裁判校准:80 条人工标签
用本地 Qwen3.5-9B 当裁判,temperature 0,两种提示词:
- 分类 rubric:给问题、标准答案、模型回答,判 correct / partial / wrong;
- 0-100 打分:同一组输入,按分段给分,再映射回三类。
80 条里 60 道可答、20 道拒答。这 20 道拒答里含 R12——6.1 已经发现它其实能由专利回答,v2 已把它退役;所以这里的「20/20 拒答正确」高估了一道。结果:
| 判定方式 | 判为 correct | 与人工一致 | κ | 精确率 | 召回率 |
|---|---|---|---|---|---|
| 字符串(5.8) | 41/60(68%) | 51/60(85%) | 0.603 | 1.00 | 0.82 |
| 裁判 · 分类 | 53/60(88%) | 51/60(85%) | 0.403 | 0.906 | 0.96 |
| 裁判 · 打分 | — | 51/60(85%) | 0.428 | — | — |
(实测,见 benchmarks/evaluation/judge-pointwise.csv 与 judge-summary.csv;80 条,本地 9B,每条回答平均 4.50 秒(可答题两次调用、拒答题一次),p95 6.12 秒。)
这张表有三个坑:
第一,准确率会被多数类抬高。 人工标签里 50/60 是 correct(83%)。一个永远输出 correct 的裁判,准确率就是 83%,κ = 0。9B 裁判的 85% 只比这个基线高 2 个百分点;κ 0.40 才是它真实的分辨力。
第二,同样的准确率,错误结构相反。 字符串判定漏 9 道、误报 0;裁判把 5 道 partial 判成 correct、把 2 道 correct 判成 partial。一个偏保守,一个偏宽容。只看「85%」会把两种完全不同的尺子当成一样。
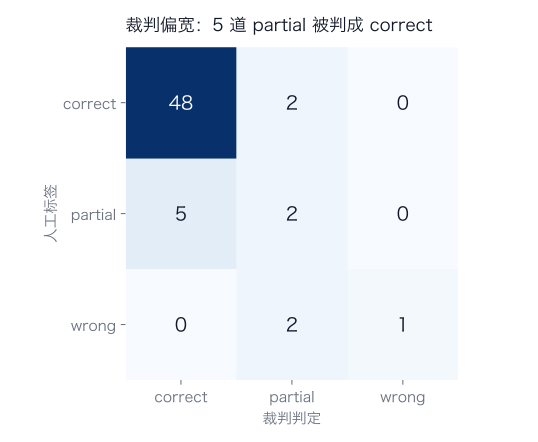
第三,分档边界会改变 κ。 分类 rubric 与 0-100 打分的标签一致率是 93%,κ 分别是 0.403 与 0.428,方向并不固定。真正敏感的是「多少分算 correct」:同一批分数,按提示词的 90 分线映射,κ = 0.428;把线降到 80 分,4 道 85 分的回答从 partial 变成 correct,κ 掉到 0.301(实测,见 judge-score-mapping.csv)。分数是模型给的,分档是你给的;报 κ 时必须把映射规则一起写出来。
拒答题单独判:20/20 全对。拒答是二分类,信号强(答案里有没有「资料中没有相关信息」),裁判在这里可靠得多。
两个偏置实验
废话偏置:给 15 道人工判 correct 的回答各补一句无害的套话(「以上内容供参考,具体执行时请结合本单位实际情况。」),再判一次。15 道全部保持 correct,翻转率 0。至少在这批数据上,长度没有把裁判带偏。
顺序偏置:同一道题,把有资料的回答与闭卷回答配成 A/B,先问一次,再交换 A/B 问一次。15 对里有 8 对(53%)的判定随顺序变化:
- D01:第一次判 B(闭卷)更好,交换后仍判 B——但 B 的内容已经换成了另一个回答;
- D02:两次都判 A,同样对应两个不同的回答;
- D03、D11、D15:第一次判 tie,交换后判 A——平局也算一次判定变化。
(实测,见 benchmarks/evaluation/judge-bias.csv。)
过半的判定变化意味着:成对比较不能只跑一个顺序。 要么交换 A/B 各跑一次、不一致就判 tie;要么改成「给标准答案、逐条判」的点式评分,减少相对位置的影响。顺序偏置在 LLM 裁判里是已知问题(引用 [2]),本机复现的量级是 53%。
忠实度:引用相关不等于引用支撑
5.8 报过「引用精确率 0.363」(66/182)——那是引用的段落是不是标准答案所在条款;按本节 205 个句-引用对重算,是 36.1%,两者几乎一样。这一节换一个更严的问题:引用的段落,是否真的支撑了它所在的那句话?
做法:把回答按句切分,句子末尾的 [n] 对应第 n 段资料;句子去掉引用标记后,与第 n 段的 4-gram 覆盖率达到 0.5 才算「有支撑」;越界引用(只有 5 段却写 [8])直接算不支撑。60 道可答题、205 个句子-引用对:
| 判定 | 结果 |
|---|---|
| 引用落在标准答案条款上(按标准答案条款重算,205 对) | 36.1% |
| 引用段落支撑该句(句级 4-gram,205 对) | 64.4% |
| 所有引用都被支撑的回答 | 53.3% |
| 所有带引用的句子都能在任意 top-5 段落里找到依据 | 68.3% |
| 9B 裁判判「忠实」 | 96.7% |
(实测,见 benchmarks/evaluation/faithfulness.csv 与 faithfulness-summary.csv;205 对里含 3 个越界引用,按不相关/不支撑计。5.8 的 66/182 按每题引用编号去重,分母不同,所以 36.3% 与 36.1% 只能看作同一量级。)
两个数字放在一起看:
- 引用相关 36.1%,引用支撑 64.4%:引用指向「相关条款」并不等于指向「支撑这句话的段落」。5.8 的引用精确率偏严,因为它要求段落落在标准答案条款上;但反过来,一个引用落在正确条款上,也可能只是「同一条法规的另一段」。
- 裁判 96.7%,程序 68.3%,κ ≈ 0.04:裁判几乎把所有回答都判成忠实。一个永远输出「忠实」的基线,与程序判定的一致率同样是 68%;κ 接近 0 说明两者的判断几乎无关。
这不是说程序判定就对。抽检能看到两边的错:X16、X20 的答案由多段资料综合而成,程序按 4-gram 判成 0 支撑,但内容确实来自资料;反过来,裁判只在 2 条上说了「不忠实」:C11 的罚款区间是算出来的,原文没有这个数,裁判这次说对了;C20 的「5 年内不得担任」在 reg-safety-law 第九十四条里有原文,程序也标 5/5 有支撑,裁判这次是假阳性。两个尺子抓的不是同一个问题。
根本问题是没有人工忠实度标签。 正确率有 60 条人工标签,忠实度没有;两个自动判定打架时,没有第三方仲裁。这一节只能证明它们不一致,不能证明谁对——这本身就是结论。
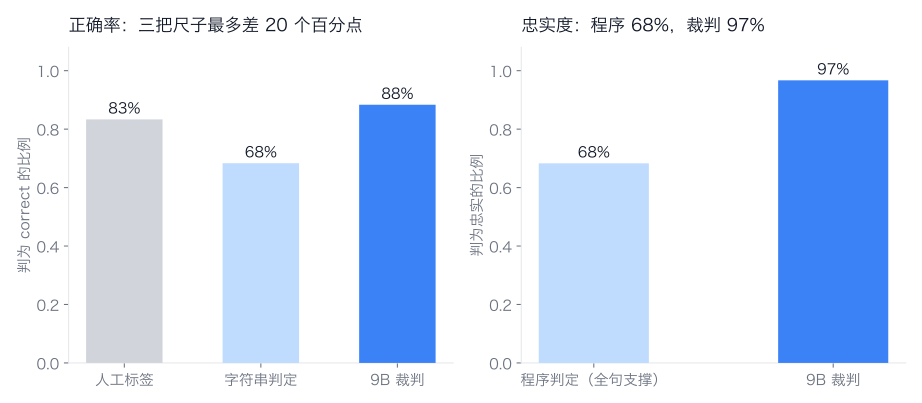
没有人工标签时,裁判分数不能当正确率
在 v2 的 test 分片上取 60 题(可答 40 + 拒答 20),用 6.2 的 RRF top-5 生成,再分别用字符串判定和裁判判。这 40 道可答题里有 5 道(C25、D34、X25、X26、X28)属于 6.2 已判定的索引缺块,其中 3 道(C25、D34、X26)甚至被裁判判成 correct——这会把 80% 抬高。它们的对错都不该算生成能力,6.5 会单独归因。
| 判定 | 判为 correct |
|---|---|
| 字符串 | 41/60(68%) |
| 9B 裁判 | 52/60(87%) |
| 两者一致 | 49/60(82%) |
(实测,见 benchmarks/evaluation/judge-v2-summary.csv。40 道可答题上差别更大:字符串 52.5%,裁判 80%。)
这两个数差了 19 个百分点;40 道可答题上是 52.5% 对 80%,差 27.5 个百分点。抽检 X21:标准答案有「督促检查、消除隐患」和「有限空间职责」两半,回答只覆盖了后半,裁判仍判 correct——裁判偏宽,不是字符串偏严那么简单。但没有人工标签,不能说哪个对。裁判可能更懂改写,也可能只是更宽容;字符串判定可能更保守,也可能漏掉了真正的错误。6.1 的教训在这里重演:没有 test 标签的分数,只能当待校准的信号,不能当正确率报给客户。
一个可操作的门槛:先人工标 50–100 条,算 κ;κ < 0.4 就不要用这个裁判做自动决策,只能用来挑出「值得人看」的样本。本书的 9B 裁判在正确率上 κ = 0.40,刚好在边界;忠实度上 κ ≈ 0.04,不能用于自动判定。
局限
- 裁判与生成是同一个模型(Qwen3.5-9B),存在自我偏好;换一个模型当裁判,κ 可能不同。本机只有一个模型,这一项没做。
- 60 道可答题里 50 条是 correct(80 条总计 70 correct / 7 partial / 3 wrong),类别不平衡,κ 的方差大;换一批题要重算,不能把 0.403 当成模型的固有属性。
- 忠实度没有人工标签,程序判定与裁判判定打架时没有仲裁者;这一节只能证明两者不一致。
- v2 的 60 条没有标签,表里的 68% 与 87% 只能说明两把尺子差多少,不能当正确率。
工程含义
先程序化,再裁判,最后人工。 拒答、数字、引用支撑都能程序判;程序判不了的部分再交给裁判;裁判的输出只用来排序或分桶,最终结论由人工标签校准。
报 κ 与混淆矩阵,不只报准确率。 多数类会把准确率抬到 80% 以上;κ、每类精确率/召回率才能说明裁判会不会把 partial 判成 correct。
裁判的版本是指标的一部分。 模型、提示词、temperature、few-shot 示例都要固定并写进报告;换一个提示词,κ 会变。
成对比较要交换顺序。 53% 的判定变化不是小数目;不做交换,等于把位置噪声当成质量差异。
忠实度和正确率分开报。 一个回答可以忠实但错误,也可以正确但引用错位;合成一个分数,就不知道修哪。
动手实验
动手实验:给 30 条回答做人工标签,算一次 κ
假设:在 30 条样本上,人工标签与 9B 裁判的 κ 会低于 0.5,主要分歧在 partial 与 correct 的边界。
做法:从 benchmarks/evaluation/judge-pointwise.csv 里抽 30 条,先遮住 strict 列,只看问题、标准答案、模型回答,自己标 correct / partial / wrong;再和裁判列比,用同一套 κ 公式算一致率。把提示词从「分类 rubric」换成「0-100 打分」,重跑 judge_calibration.py,看 κ 怎么变。
记录:κ、混淆矩阵、分歧最大的 5 条及原因、两种提示词的 κ 差。注意:30 条的 κ 置信区间很宽,只能用来发现明显问题,不能用来给裁判定版。
参考资料
- Zheng, L. et al. Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena(LLM 裁判与人工偏好的一致率、位置/长度偏置,NeurIPS 2023). https://arxiv.org/abs/2306.05685
- Wang, P. et al. Large Language Models are not Fair Evaluators(成对比较中的位置偏置与交换顺序的校正). https://arxiv.org/abs/2305.17926
- Es, S. et al. RAGAS: Automated Evaluation of Retrieval Augmented Generation(忠实度、答案相关性等 RAG 指标的自动评估框架). https://arxiv.org/abs/2309.15217