

主题
带宽瓶颈:为什么推理速度看内存带宽而不是算力
本章要回答的问题:显卡算力年年翻倍,为什么本地推理速度没跟着涨?为什么说瓶颈在内存带宽?
一条可以背下来的估算式
对逐 token 生成的阶段(decode),速度上限近似等于:
每秒 token 数上限 ≈ 内存带宽 ÷ 每 token 需要读取的字节数"每 token 需要读取的字节数"在 dense 模型里就是全部权重的字节数。因为每生成一个 token,模型里每个参与计算的权重都要从内存搬到计算单元一次,读完就用完,不留在片上。
以本书主力模型为例(Qwen3.5-9B 的 Q4_K_M 为 5.68 GB,引用 [1]):
| 设备 | 带宽(引用) | 理论 decode 上限(估算) |
|---|---|---|
| Apple M4(统一内存) | 120 GB/s(引用 [2]) | 约 21 token/s |
| RTX 4090(GDDR6X) | 1008 GB/s(引用 [3]) | 约 177 token/s |
| H100 SXM(HBM3) | 3.35 TB/s(引用 [4]) | 约 590 token/s |
差距接近 30 倍,而三块芯片的峰值算力差距还要更大。**如果推理是算力瓶颈,M4 应该慢几百倍;实际只慢了二三十倍,这本身就说明瓶颈不在算力。**把三块芯片和实测点画在同一张对数图上(图 1.5-1),这条关系更直接:三点几乎落在一条直线上。
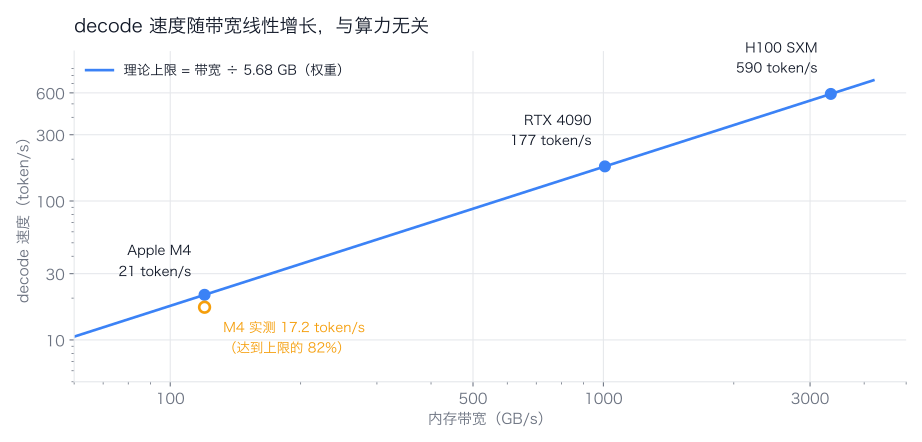
反过来验算:21 token/s × 9B 参数 × 每参数 2 次浮点运算 ≈ 3.8 × 10¹¹ FLOP/s(估算)。M4 的 GPU 峰值算力在 TFLOP/s 量级,也就是说 decode 阶段只用到了个位数百分比的算力。剩下的时间都在等内存。
为什么每 token 必须把权重读一遍
这和矩阵乘的形状有关。
假设隐藏维度是 4096,一次前馈层计算是 [1, 4096] × [4096, 12288]。右边那个矩阵有 5000 多万个数,每个数只参与一次乘加就被丢弃。下一次计算换一个 token,同样的矩阵还要再读一遍。
这就是"算术强度低":搬运的数据量远大于计算量。Roofline 模型把这种情况称为"内存受限"(memory-bound):性能上限由带宽决定,加算力没用(引用 [5])。Pope 等人的分析给出了同样的结论:自回归解码的瓶颈是权重读取,而不是浮点运算(引用 [6])。
Prefill 则相反。同样是那个矩阵,如果一次处理 512 个 token,就是 [512, 4096] × [4096, 12288],权重读一次服务 512 个 token,算术强度提高 512 倍,瓶颈转到算力。这就是 1.3 节里 prefill 和 decode 表现迥异的原因。
三个直接推论
推论一:量化几乎线性地提升 decode 速度。 权重从 16 位降到 4 位,字节数降到约 1/4,理论速度提升约 4 倍。前提是反量化开销可以忽略——在 CPU 和 Apple GPU 上,这个前提并不总成立,所以实测提升通常在 2–3 倍之间(估算,具体取决于引擎和算子实现)。第四部分会量化这条曲线。
推论二:批处理能提高吞吐,但不能降低单请求延迟。 一个 batch 里 8 个请求,权重只读一次,服务 8 个 token,总吞吐接近 8 倍。但每个请求的等待时间并没有缩短,甚至因为要算更多向量而略长。这是"吞吐"和"延迟"的经典权衡,也是服务端配置的核心矛盾。
推论三:MoE 的速度由激活参数决定,内存由总参数决定。 Gemma-4-26B-A4B 总参数 26B,每个 token 只激活约 4B(引用 [7])。按激活部分估算,每 token 需要读的权重大约是 26B 模型文件的 4/26,即 16.95 GB × 4/26 ≈ 2.6 GB(估算)——理论上比 9B dense 还快,但显存要按 17 GB 准备。2.3 节专门讲这个反直觉的结论。
什么时候不是带宽瓶颈
这条估算式不是万能的,至少有四种例外:
- Prompt 很长、输出很短。 时间主要花在 prefill,受算力限制,带宽公式解释不了。
- batch 很大。 权重被摊薄后,KV Cache 的读取和计算开始占主导。
- 极低比特量化。 权重读取变少之后,反量化的指令开销和访存不连续可能成为新瓶颈。
- CPU 推理。 CPU 的内存带宽通常只有几十 GB/s,且多核共享,瓶颈更早出现,但也更容易被其他进程干扰。
所以看到"实测比理论慢很多"时,不要急着怀疑公式,先看是不是踩到了上面某一条。
为什么显卡还在堆算力
既然 decode 卡在带宽,厂商为什么继续堆算力?因为训练和大 batch 的 prefill 确实吃算力,而这些是更赚钱的场景。推理侧的对策不是堆算力,而是提高每次读取的利用率:更大的 batch、更低的量化位宽、更好的 KV 管理、投机解码。这也是第七部分要讲的内容。
对个人和小团队来说,这条结论更实际:选硬件时先看带宽和容量,再看算力。 一张带宽翻倍、显存相同的卡,对本地推理的意义远大于算力翻倍。
动手实验
动手实验:带宽利用率
假设:实测 decode 速度达到理论上限的 50%–80%;MoE 模型的实测速度明显高于同文件大小的 dense 模型。
命令:
bash
# 主力模型必做
llama-bench -m "$MODEL" -p 512 -n 128 -r 5 -o csv

# 可选对照:同参数换模型(需另行下载,见 2.6 节)
llama-bench -m Qwen3-14B-Q4_K_M.gguf        -p 512 -n 128 -r 5 -o csv
llama-bench -m Gemma-4-26B-A4B-Q4_K_M.gguf -p 512 -n 128 -r 5 -o csv记录:tg128 的实测值,与"带宽 ÷ 权重字节"算出的上限相比,得到利用率。权重字节数取 llama-bench 输出里的 size 列,或直接看 GGUF 文件大小。同时记录峰值内存(用 /usr/bin/time -l 包住同一条命令),验证 MoE 的"内存按总参数、速度按激活参数"。数据存 benchmarks/bandwidth/。
参考资料
- Unsloth. Qwen3.5-9B-GGUF(
Qwen3.5-9B-Q4_K_M.gguf,5.68 GB). https://huggingface.co/unsloth/Qwen3.5-9B-GGUF - Apple. Apple introduces M4 Pro and M4 Max(M4 内存带宽 120 GB/s). https://www.apple.com/newsroom/2024/10/apple-introduces-m4-pro-and-m4-max/
- NVIDIA. GeForce RTX 4090 规格页(显存带宽 1008 GB/s). https://www.nvidia.com/en-us/geforce/graphics-cards/40-series/rtx-4090/
- NVIDIA. NVIDIA H100 Tensor Core GPU(HBM3,3.35 TB/s). https://www.nvidia.com/en-us/data-center/h100/
- Williams, S., Waterman, A., Patterson, D. Roofline: An Insightful Visual Performance Model for Multicore Architectures. Communications of the ACM, 2009. https://doi.org/10.1145/1498765.1498785
- Pope, R. et al. Efficiently Scaling Transformer Inference. arXiv:2211.05102. https://arxiv.org/abs/2211.05102
- Google. Gemma-4-26B-A4B-it 模型卡(总参数 26B,激活参数约 4B). https://huggingface.co/google/gemma-4-26B-A4B-it