

主题
为什么用 RAG:对比微调与长上下文
本章要回答的问题:要让模型懂公司资料,微调、塞进长上下文、还是 RAG?三条路怎么选?
模型不知道你的资料,这是所有私有化落地的起点。三条路看起来都能走:
- 微调:把资料写进训练数据,改模型参数;
- 长上下文:不检索,把整份资料塞进 prompt;
- RAG:先检索相关片段,再让模型基于片段回答。
这一节不做微调(全书不覆盖训练),但会把另外两条路在同一台机器上量出来,再给一张选择表。
微调改的是行为,不是记忆
微调擅长的是格式、语气、任务模式:让模型按固定 JSON 输出、按公司话术回答、按某类推理步骤解题。 它不擅长可靠地记住事实。
原因不神秘:一次微调只让模型在训练样本上多走几遍梯度,事实是否被记住、记住后会不会被旧知识覆盖、更新资料后怎么忘掉旧版本,都没有保证。 把“知识注入”完全交给微调,常见结果是:模型答得更像那么回事,但引用和数字更容易编(引用 [2])。
所以本书的立场是:微调用于行为,RAG 用于事实。 两者可以叠加,但不能互相替代。
长上下文:能塞进去,但很贵
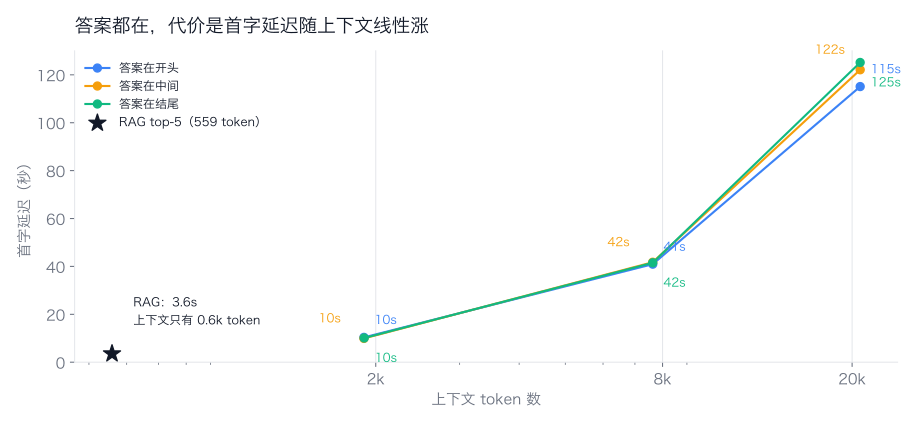
Qwen3.5-9B 支持 32k 上下文。把语料里 4000 / 16000 / 40000 字(约 1.9k / 7.6k / 20.8k token)的正文塞进 prompt,在开头、中间、结尾各埋一句答案,问同一个问题:从业人员超过一百人的其他生产经营单位,应当如何配备安全生产管理人员?
| 上下文 token | 首字延迟(开头 / 中间 / 结尾) | 是否命中 |
|---|---|---|
| 1.9k | 10.4 / 9.9 / 10.1 s | 3/3 |
| 7.6k | 41.0 / 41.8 / 41.5 s | 3/3 |
| 20.8k | 115.1 / 122.1 / 125.2 s | 3/3 |
(实测,见 benchmarks/rag/long-context.csv;M4 24GB,Qwen3.5-9B-Q4_K_M,温度 0)
三件事很明确:
第一,答案在哪个位置都能找到。 9 次全部命中,没有出现“中间位置丢失”。这和 Lost in the Middle 的结论不矛盾:那篇论文测的是多文档、需要综合多个位置的任务(引用 [1]);单一事实的“大海捞针”是更简单的任务,本来就不容易丢。
第二,首字延迟随上下文线性涨。 1.9k → 20.8k,token 数涨 11 倍,首字延迟从 10 秒涨到 115–125 秒,基本同比例。M4 上的预填充速度约 170 token/s,这是硬约束。
第三,RAG 的上下文小一个数量级。 同一问题,top-5 只用了 559 token,首字延迟 3.6 秒。
这还只是一次查询、一个事实。真实问答里,用户会连续问、会追问、会一次问三件事;每次都把 2 万 token 重新预填充一遍,交互体验和电费都撑不住。
长上下文什么时候仍然值得
不是所有场景都要 RAG。下面几种情况,直接塞上下文更简单:
- 资料总量小于上下文窗口(比如一份 20 页的合同、一份设备手册),且不常变;
- 问题需要通读全文才能回答(总结、对比、找矛盾),检索反而会切碎证据;
- 查询频率低(一天几次),延迟不敏感;
- 还没有语料治理能力,先跑通再谈检索。
反过来,下面这些情况 RAG 更合适:
- 资料持续增长、频繁更新;
- 需要按权限过滤(不同人看到不同片段);
- 需要标出处、可回查;
- 并发高、延迟敏感;
- 资料量远超上下文窗口。
三条路的对照
| 维度 | 微调 | 长上下文 | RAG |
|---|---|---|---|
| 注入事实 | 不可靠 | 临时、每次都要带 | 可靠,可更新 |
| 更新资料 | 重新训练 | 改 prompt 即可 | 重建对应块 |
| 引用出处 | 无 | 只能指到整份文档 | 可指到段/条款/页 |
| 权限 | 难(同一模型) | 靠 prompt 约束 | 可在检索前过滤 |
| 延迟 | 低(上下文短) | 随上下文线性涨 | 检索 + 短上下文 |
| 成本 | 训练一次,推理便宜 | 每次查询都付长上下文 | 索引 + 短上下文 |
| 适合 | 格式/风格/任务 | 小语料、低频、通读 | 大语料、更新、权限 |
(延迟与成本两行来自本节实测与 5.5 的索引数据;训练成本本书未测。)
一个常见的组合是:RAG 负责事实,微调负责表达。先用 RAG 把答案找对,再用一个小模型或提示词把答案说得像公司的人;不要指望微调把资料背下来。
工程含义
默认选 RAG,除非资料小到能整份塞进去。 这不是技术偏好,是成本结构:RAG 的边际成本是“检索 + 1k token”,长上下文的边际成本是“全文 token”。
长上下文不是 RAG 的替代品,是兜底。 检索失败、问题需要通读、资料刚更新还没入库时,长上下文可以救场;把它当主路径,延迟会先撑不住。
微调前先问:我要改的是行为还是事实? 行为(格式、语气、流程)可以微调;事实(条款、参数、客户)走 RAG,并保留出处。
把“上下文预算”当容量规划的一部分。 20.8k token 的首字延迟 111 秒,这个数字决定了交互形态:是聊天,还是批处理。
动手实验
动手实验:多针、干扰与 128k
假设:当上下文里同时埋 5 个事实、并加入语义相近的干扰段时,中间位置的命中率会明显下降;上下文超过 64k 后,M4 上的首字延迟会超过 5 分钟。
做法:把 long_context.py 的单针改成 5 针,答案分别放在 5 个段落;每个位置放 3 个语义相近但数字不同的干扰段;上下文长度扩到 64k(需要更大的 -c,并监控内存)。
记录:各位置的命中率、首字延迟、显存峰值。注意:这是单模型、单机器的结论;换模型或换量化,位置效应会变。
参考资料
- Liu, N. F. et al. Lost in the Middle: How Language Models Use Long Contexts(多文档长上下文中的位置效应,TACL 2024). https://arxiv.org/abs/2307.03172
- Ovadia, O. et al. Fine-Tuning or Retrieval? Comparing Knowledge Injection in LLMs(微调与检索注入事实的对比,2023). https://arxiv.org/abs/2312.05934
- Lewis, P. et al. Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks(RAG 的原始公式,NeurIPS 2020). https://arxiv.org/abs/2005.11401