

主题
检索指标:Recall@k / MRR / nDCG
本章要回答的问题:这三个指标分别在惩罚什么错误?我该看哪一个?
6.1 造好了尺子,这一节决定读哪根刻度。第五部分已经用过这三个指标,但没有解释它们的分工:同样是 top-5,Recall 只看「有没有」,MRR 只看「第一条」,nDCG 看整条排序。选错指标,优化的方向就会错。
这一节在 v2 的 test 分片上重算三个指标,并回答三个具体问题:召回贴顶之后还看不看得出差别?哪一类题在拖后腿?4 个百分点的差距是不是噪声?
三个指标分别在惩罚什么
假设一道题只有一个相关块,它排在第 r 位:
| 唯一相关块的位置 | Recall@5 | MRR@10 | nDCG@10 |
|---|---|---|---|
| 第 1 位 | 1 | 1.000 | 1.000 |
| 第 3 位 | 1 | 0.333 | 0.500 |
| 第 6 位 | 0 | 0.167 | 0.356 |
三个指标的分歧一目了然:
- Recall@k 是二值的:前 k 条里有没有相关块。它惩罚「漏」,完全不管排第几。第 1 位和第 5 位在 Recall@5 里一样好。
- MRR@k 只看第一条相关块的位置,取倒数。它惩罚「第一条不准」,不惩罚第二条以后;第 6 位仍然有 0.167。
- nDCG@k 用对数折扣累计所有相关块,位置越靠后权重越低。它是三者里最接近「整体排序质量」的一个(引用 [2])。
MRR 在 TREC 的问答评估里被用来衡量「第一个正确回答排多靠前」(引用 [1]);nDCG 则来自带分级相关度的排序评估。本书的相关性只有「相关 / 不相关」两档,所以 nDCG 的增益取 0 或 1,IDCG 取相关块数的理想排序。
指标定义、pooled 评估与截断的经典讨论在 IR 教材第 8 章(引用 [3])。
测量设置:先查金标在不在索引里
在比检索器之前,先确认每道题的标准答案真的能从索引里检索到。这一步在第五部分被跳过了,代价是这一节的 8 道题被排除。
v2 的 test 分片有 150 题,其中 113 道可答。用 5.4 的 734 个真实块做金标覆盖检查:如果没有任何一个块覆盖某一条答案片段(按「;」「。」切分)的 50% 以上(4-gram 覆盖率 0.5),这道题就不该算进检索指标。
结果:105 道题有金标,8 道没有(实测,见 benchmarks/evaluation/retrieval-excluded.csv)。缺的是 4 条条款的正文:
- 《安全生产法》第六条、第四十七条;
- 《工贸企业有限空间作业安全规定》第十条、第十一条。
这 4 条在 5.3 的按结构切分里没有进块——min_chunk 是 60 字,33–50 字的短条款被直接丢弃,正文没有进索引,条号也跟着错位。这不是检索器的错,是索引的错。修法只有一个:重切、重跑第五部分的检索实验;本节先把这 8 题排除,避免把索引缺口算成召回失败。
排除后要分清两种失败:4 道单出处题(D34、D51、C25、C48)的 Recall@5 直接记 0;4 道跨段题(X25、X26、X28、X47)有一个出处还在索引里,Recall@5 仍可能命中,但 joint Recall@5 记 0。
相关性口径也一并改了:按答案原文判,不按条款号判。原因在 6.1 已经说过——汇编类文档里同一个条号可能指向不同法规的条文;在这套索引上,按条号判还会漏掉条号错位的块。两种口径的差异见后文。
检索器还是三个:BM25、稠密检索(Qwen3-Embedding-0.6B)与 RRF 融合,参数与 5.6 一致。所有的比较都在同一批 105 道题上做,配对。
结果:召回贴顶,排序还有差距
| 策略 | Recall@1 | Recall@5 | Recall@10 | MRR@10 | nDCG@10 | joint Recall@5 |
|---|---|---|---|---|---|---|
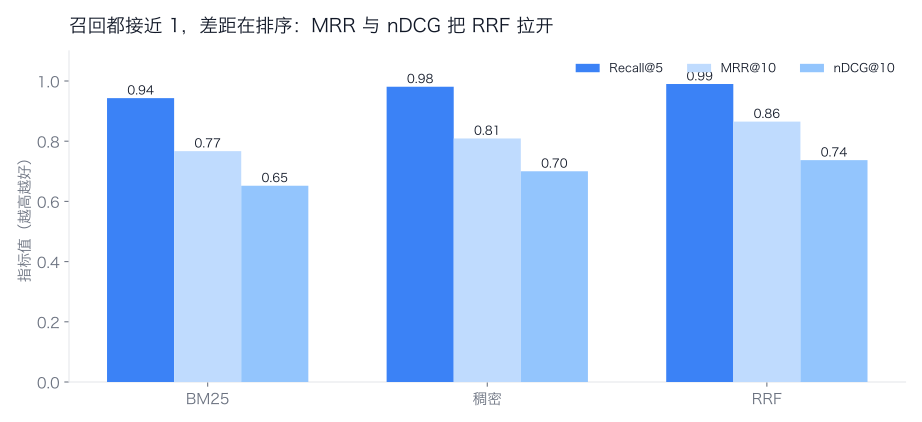
| BM25 | 0.638 | 0.943 | 0.962 | 0.767 | 0.652 | 0.471 |
| 稠密 | 0.695 | 0.981 | 1.000 | 0.809 | 0.700 | 0.559 |
| RRF | 0.771 | 0.990 | 0.990 | 0.865 | 0.737 | 0.618 |
(实测,见 benchmarks/evaluation/retrieval-metrics.csv;105 道 test 可答题。)
三个读数:
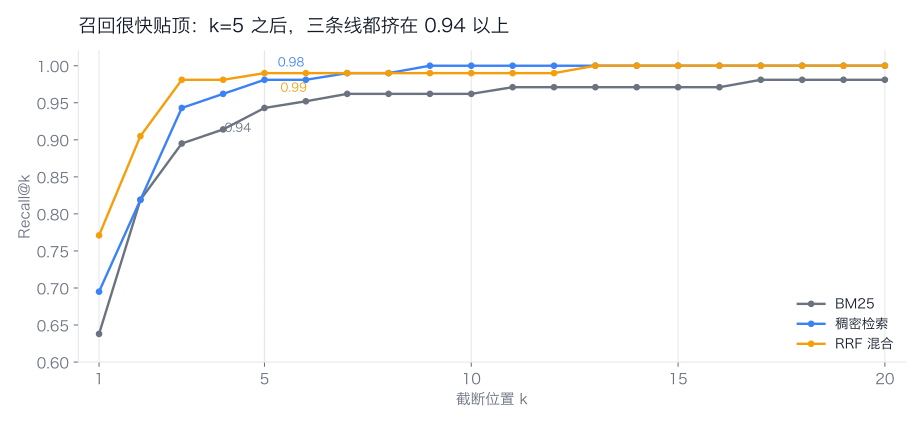
第一,Recall@5 已经贴顶。 稠密 0.981、RRF 0.990,再往上加候选只能在最后 1–2 个百分点里挤。这个 test 分片已经不适合回答「谁的召回更高」——不是检索器没差别,是尺子的量程到了。5.x 的 0.967 与这里的 0.981 也不能直接比——0.967 是 60 道 v1 非拒答题;v2 test 的跨段题比例与 v1 接近(都约 1/3),差别在语料与具体条款,不在题型比例。
第二,差距在排序。 BM25 到 RRF,Recall@5 只涨 4.8 个百分点,MRR 涨 9.8 个百分点,nDCG 涨 8.5 个百分点。稀疏检索靠关键词命中,能进前 5,但第一条经常不是最相关的;稠密加融合把第一条推得更准。只看 Recall,会得出「三者差不多」的结论——5.6 里融合在语义题上不如纯向量、在标识符题上才反超,平均分看不出这种分工。
第三,跨段题是瓶颈。 单看 Recall@5,稠密的跨段题是 1.000,似乎全找到了;但 joint Recall@5 只有 0.559——只有一半多一点的题把两个出处都放进了前 5。单段召回把「只找到一半」藏了起来,这是 5.6 里 joint recall 存在的理由,也是 6.1 坚持 joint: true 的理由。
分题型看(稠密,answer 口径):
| 题型 | n | Recall@5 | MRR@10 | joint Recall@5 |
|---|---|---|---|---|
| 直接摘取 | 36 | 0.944 | 0.814 | — |
| 条件判断 | 35 | 1.000 | 0.786 | — |
| 跨段组合 | 34 | 1.000 | 0.829 | 0.559 |
(实测,见 benchmarks/evaluation/retrieval-metrics.csv。)
跨段题的单段召回满分、联合召回 0.56,说明失败不在「找不到」,在「只找到一条」。如果下游只把 top-5 里的头两条塞给模型,跨段题会稳定地答不全。
两种「相关」口径差多少
同一批题、同一批检索结果,只换「什么算相关」:
| 口径 | Recall@5 | MRR@10 | nDCG@10 |
|---|---|---|---|
| 按答案原文(本书) | 0.981 | 0.809 | 0.700 |
| 按条款号(第五部分) | 0.962 | 0.774 | 0.703 |
(稠密检索,105 道题;实测,见 retrieval-metrics.csv 的 relevance=clause 行。)
差 2 个百分点,不是「按条号更严」,而是条号在这套索引上不可靠:漏块、并块、同一个条号指不同法规。按条号判,正确答案可能因为块上的标签错位而被判失败;反过来,汇编里同号的另一段也可能被判成功。两个方向的误差混在一起,净效果看起来只是「低了一点」,但已经不可解释。
相关性要按内容判,不按 ID 判。 即便在同一份文档里,块标签错位也会让两种口径差约 2 个百分点(安全生产法上 0.981 对 0.962);跨文档的汇编只会更糟。按 ID 判出来的数字不能拿去下结论。这条规则不只适用于检索:6.3 判生成答案、6.4 做消融,都要求「相关」的定义能落到原文。
4 个百分点的差距是不是噪声
105 道题,配对比较:
| 对比 | 指标 | 差值 | 95% CI | McNemar p |
|---|---|---|---|---|
| 稠密 vs BM25 | Recall@5 | +3.8pp | [0.0, 8.6] | 0.219 |
| RRF vs BM25 | Recall@5 | +4.8pp | [1.0, 8.6] | 0.063 |
| RRF vs 稠密 | Recall@5 | +1.0pp | [−1.9, 3.8] | 1.000 |
| RRF vs 稠密 | MRR@10 | +5.6pp | [0.3, 11.0] | — |
| RRF vs 稠密 | nDCG@10 | +3.7pp | [0.5, 6.9] | — |
(实测,见 benchmarks/evaluation/retrieval-paired.csv;配对 bootstrap 2000 次,McNemar 双侧精确检验。)
读法:
- 稠密比 BM25 的召回高 3.8 个百分点,但区间下界是 0,p=0.219。 6 道不一致的题里有 5 道是稠密对、BM25 错;样本太少,不能宣布「稠密更好」。
- RRF 比 BM25 高 4.8 个百分点,p=0.063,在 0.05 边缘。把可答题扩到 200 道可能就显著了,但这批题只能说到这里。
- RRF 与稠密的召回差 1.0 个百分点,完全在噪声里;差别在 MRR(+5.6,CI 不含 0)与 nDCG(+3.7,CI 不含 0)。也就是说,融合的主要收益不是「多召回一条」,是「把第一条排对」。
这组数字就是 6.1 说的功效问题:105 道题能分辨 5 个百分点左右的排序差异,分辨不了 2–3 个百分点的召回差异。报「RRF 比稠密好 1.0 个点」而不报区间,是在制造结论。
换一个相关性阈值,数字会动多少
「一个块覆盖某一条答案片段的 50%」是本书的口径。把阈值从 0.35 调到 0.65,同一批检索结果会变:
| 阈值 | 稠密 Recall@5 | 稠密 MRR@10 | RRF Recall@5 | RRF MRR@10 |
|---|---|---|---|---|
| 0.35 | 0.981 | 0.828 | 0.990 | 0.889 |
| 0.50 | 0.981 | 0.809 | 0.990 | 0.865 |
| 0.65 | 0.971 | 0.801 | 0.990 | 0.848 |
(实测,见 benchmarks/evaluation/retrieval-threshold.csv。)
Recall@5 基本不动,MRR 动 2–4 个百分点。原因:召回看「有没有一条」,阈值松紧只影响边缘块;MRR 看「第一条」,阈值一严,原本排第一的块可能不算相关,第一条的位置就往后挪。
所以报指标时必须带口径:相关性怎么判、k 取多少、阈值多少。没有口径的 0.86 和 0.87 不值得讨论。
该看哪一个
- 只关心「资料找没找到」:Recall@5,加上跨段题的 joint Recall@5。
- 只把第一条给模型:MRR@10,加上 Recall@1。
- 排序要展示给人看:nDCG@10,三者一起报。
- 跨段题:必须单独报 joint recall,单段 Recall 会把它藏起来。
一个实用的顺序:先看 joint Recall@5(会答吗),再看 Recall@5(找得到吗),最后看 MRR 与 nDCG(排得对吗)。只看第一项会漏掉排序,只看最后一项会漏掉多段题。
局限
- 按片段判相关:一个块只要覆盖某条答案片段的 50% 就算,短套话(如刑法条款的兜底句)会把含相同措辞的块带进来。主表的召回在整答案口径下不变,MRR 的绝对值会受影响。
- 105 道题只够分辨 5 个百分点左右;更细的差异要么扩题,要么换更强的配对设计。
- 8 道题被排除,它们可能比留下的题更难;补回短条款后,绝对指标大概率会降。
工程含义
先查索引覆盖,再比检索器。 8/113 道题的金标不在索引里,不先排除,4 道单出处题的 Recall@5、4 道跨段题的 joint Recall@5 都是 0;你会以为是模型不行,实际是切块漏了。
相关性口径写进代码。 按答案原文匹配比按条号稳;ID 不稳定时,按 ID 判的相关性会把错误藏起来。
test 只适合做有限次比较。 105 道题、5 个预注册的对比,是这个分片的量程;反复试到显著为止,test 就被调成了 dev。
配对比较 + 区间是底线。 同一道题上的对错变化才有信息;两个独立比例相减,4 个百分点看不出真假。
动手实验
动手实验:修好漏块,再看召回怎么变
假设:把 5.3 因 min_chunk=60 丢掉的 4 条短条款补进索引后,被排除的 8 道题能回到测试集,稠密的 Recall@5 会从 0.981 降到 0.96 附近——因为补回来的题更难。
做法:把 labs/05-rag/config.yaml 的 min_chunk 从 60 降到 20,或改 labs/05-rag/raglib.py 把过短的片段并入相邻块,让短条款单独成块;删掉 .cache/chunks-structure-real.jsonl 与 vectors-1024-real.npy,重跑 chunking.py、embed_index.py、retrieve.py。然后用同一份 qa-v2.jsonl 的 test 分片重跑 retrieval_metrics.py。
记录:块数、被排除题数、Recall@5 与 joint Recall@5 的变化、以及第五部分哪些数字跟着变了。注意:重切会改变 5.x 的所有历史数字,先确认你能不能接受这次重跑。
参考资料
- Voorhees, E. M. The TREC-8 Question Answering Track Report(问答评估与第一个正确答案的位置,TREC 1999). https://trec.nist.gov/pubs/trec8/papers/qa_report.pdf
- Järvelin, K., Kekäläinen, J. Cumulated Gain-based Evaluation of IR Techniques(nDCG 的定义与折扣累计增益,ACM TOIS 2002). https://doi.org/10.1145/582415.582418
- Manning, C. D., Raghavan, P., Schütze, H. Introduction to Information Retrieval, Chapter 8: Evaluation in Information Retrieval(Recall、MRR、pooled 评估与截断的经典讨论,Cambridge University Press, 2008). https://doi.org/10.1017/CBO9780511809071