

主题
评估量化损失:困惑度、任务正确率,以及各自的局限
本章要回答的问题:怎么用数据证明 Q4 对我的任务"够用"?困惑度变差就等于不能用吗?
前四节讲的是怎么压。这一节讲怎么判断压完还能不能用——以及为什么大多数"量化无损"的说法都不成立。
先说结论:没有一个指标能单独回答这个问题。困惑度分辨率高但离业务远,任务正确率贴业务但噪声大,KL 散度看得最细但要额外算。你得知道每个指标能看见多大的变化,再选一个配得上你要检测的效应。
困惑度:只在自己跟自己比时有效
困惑度(perplexity,PPL)是模型对一段文本的"惊讶程度":每个 token 的平均负对数似然的指数。越低说明模型越觉得这段文本顺。
问题在于,它的绝对值完全没有跨语料的可比性。同一个模型、同一套参数,只换语料域:
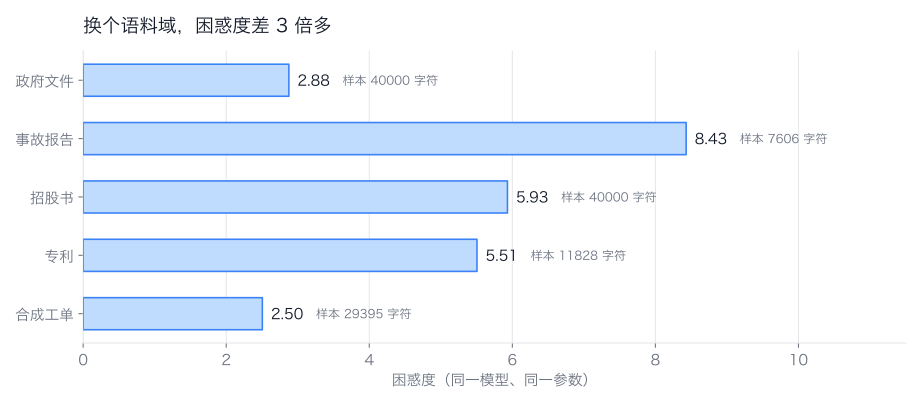
合成工单 2.50,事故报告 8.43,差 3.4 倍。两个数字都是真的,但拿它们互相比较毫无意义——事故报告的行文本来就比模板化的工单难预测。
所以困惑度只有一种用法:固定同一段文本,比较两个模型(或两档量化)。这时它分辨率很高。本地同一段文本重复跑两次,结果完全一样(2.6147 对 2.6147,实测,见 benchmarks/quantization/determinism.txt);4.5 节里 KV 类型换一下,0.0007 的差异也能稳定复现。报告的 ±0.11 是块间标准差,不是重复误差——别把它当置信区间用。
任务正确率:贴业务,但分辨率粗
困惑度的第二个问题是它不告诉你"答得对不对"。要回答这个,只能用你自己的题。
拿 60 道合成工单的字段抽取题(labs/04-quantization/task_probe.py),同一模型跑三遍:
| 运行 | 温度 | 正确数 | 正确率 | 95% 区间(Wilson) |
|---|---|---|---|---|
| 1 | 0 | 59/60 | 98.3% | 91.1% – 99.7% |
| 2 | 0.7 | 57/60 | 95.0% | 86.3% – 98.3% |
| 3 | 0.7 | 58/60 | 96.7% | 88.6% – 99.1% |
(实测,见 benchmarks/quantization/task-probe.csv)
看第三列和第五列的对比:三次运行的极差是 3.3 个百分点,而 95% 区间宽 8–12 个百分点。换句话说,如果某档量化让正确率掉了 3 个点,用 60 道题根本测不出来——你会把它当成随机波动。
这不是模型的问题,是样本量的问题。二项分布的区间宽度大致按 1/√n 收缩:
- 60 题、正确率 95% 时,区间约 ±6 个百分点;
- 240 题时约 ±3 个百分点;
- 1000 题时约 ±1.4 个百分点。
要检测 2 个点的差异,至少得几百道题,而且要用同一批题做配对比较(同一道题,两档模型谁对谁错),否则题目难度差异会盖过量化差异。
温度 0.7 下的两次运行还暴露了另一件事:同一档模型、同一批题,换个种子就能差 2–3 个点。任何"某档量化掉了 X%"的结论,如果没写温度和种子数,基本没法复现。
KL 散度:看得最细,也最贵
困惑度只看"正确 token 的概率",KL 散度看整个词表分布的形状变化:
KL(P‖Q) = Σ P(w) · log(P(w) / Q(w))它要同时跑原始模型和量化模型,把每个位置的 logits 存下来对比。llama.cpp 的 llama-perplexity 支持这个模式:先用 16 位模型跑一遍存 logits(--kl-divergence-base),再让量化模型对着它算。
好处是灵敏度高,能在困惑度还没明显变化时就发现分布偏移;坏处是贵——要 16 位源、要存中间结果、跑两遍。本书没做这一步,因为它的结论和困惑度高度相关,而成本高一倍。真要做回归测试的团队值得加上。
三个指标的分辨率对照
| 指标 | 能看见多大的变化 | 成本 | 离业务多远 |
|---|---|---|---|
| 困惑度 | 0.01% 量级(同文本) | 低,几分钟 | 远 |
| KL 散度 | 更细 | 高,要 16 位源 + 两遍 | 中 |
| 任务正确率(60 题) | 5–10 个百分点 | 中,几分钟到几十分钟 | 近 |
4.5 节那个例子正好说明这个差别:KV 从 f16 换到 q4_0,困惑度涨 0.24%(看得见),而 60 题探针的正确率一动没动(看不见)。两个结论不矛盾,只是尺子不同。
怎么给"够用"下定义
一个可操作的流程:
- 先定业务指标。 不是"困惑度不超过 X",而是"抽取任务正确率 ≥ 95%"或"拒答率 ≤ 5%"。
- 建题集,宁多勿少。 60 题只能做冒烟测试;要下结论,200 题起步,四类题(直接摘取、跨段组合、条件判断、拒答)各占一定比例。
- 固定变量做配对比较。 同一批题、同一温度、同一 seed 列表,只换量化档。报告差值时带上区间。
- 困惑度当哨兵,不当裁判。 它涨得明显(比如 >1%)就值得警惕;它没涨也不代表任务没退化。
- 记录硬件与命令。 换了机器、换了 llama.cpp 版本,数字都可能变,尤其是 KV 量化那条慢路径。
工程含义
"Q4 无损"是一句没有信息量的话。 无损于什么?在多长的上下文、什么任务、多少题上?三个都没说,就没法验证。
效应小的时候,换更细的尺子,而不是加更多题。 想确认 0.2% 的困惑度差异是否要紧,做 1000 道题不如直接看 KL 或下游任务的错误类型。
量化损失常常表现为"稳定性变差",而不是"正确率下降"。 同一道题多跑几次,Q4 的答案更容易飘。如果你的指标只测一次,就会漏掉这类退化——这也解释了为什么温度 0.7 的两次运行值得单独看。
动手实验
动手实验:用 240 道题看区间怎么收
假设:题量从 60 翻到 240 后,95% 区间从 ±6 个百分点收到 ±3 个百分点,足以分辨 Q4_K_M 与 Q5_K_M 的差异。
做法:eval/qa-v2.jsonl 已有 300 题(四类各 75,见 6.1),取其中 240 道即可,不必重新出题。注意 task_probe.py 只按合成工单的字段精确判分,不能直接读 qa-v2;要先用 5.8 的子串/数字判定(或 eval/validate.py 的答案口径)把它改成通用判分,再跑两档量化。
记录:两档的正确率、区间、以及配对比较下"仅一档答对"的题数。注意:题目要从真实语料出,合成工单只能测格式遵循,测不出业务理解。
参考资料
- Dettmers, T., Zettlemoyer, L. The case for 4-bit precision: k-bit Inference Scaling Laws(总位数与零样本精度的关系,4 位的经验最优点). https://arxiv.org/abs/2212.09720
- ggml 项目.
tools/perplexity/README.md(困惑度与--kl-divergence-base的用法). https://github.com/ggml-org/llama.cpp/blob/master/tools/perplexity/README.md - Liu, Z. et al. KIVI: A Tuning-Free Asymmetric 2bit Quantization for KV Cache(量化误差在长上下文下的累积). https://arxiv.org/abs/2402.02750
- Wilson, E. B. Probable Inference, the Law of Succession, and Statistical Inference(二项比例的 Wilson 区间,JASA 1927). https://doi.org/10.1080/01621459.1927.10502953