

主题
切分:按长度、按结构、按语义,以及表格怎么处理
本章要回答的问题:文档该切成多大?按长度切和按结构切差别有多大?表格切断了怎么办?
切分不是“把长文切短”,是决定检索的最小单位。切大了,一个块里混着几个主题,向量被平均掉;切小了,一句话被拆成两半,答案和出处对不上。
这一节用同一份语料、同一套向量模型,只换切法,看召回怎么变。
块长到底在权衡什么
块长同时影响三件事:
- 向量表达:块越长,一个向量要概括的主题越多,语义越糊;
- 检索粒度:块越短,命中越精确,但同一段答案可能被拆成多块,召回要碰运气;
- 生成成本:top-5 的块越长,塞进上下文的 token 越多,首字延迟和费用越高。
经验起点是 200–500 字(中文)。Dense Passage Retrieval 的训练数据用的是 100 词左右的段落(引用 [1]),那是英文;中文 400 字大致对应 250–300 个 Qwen token,本书取 400 字、重叠 80 字。
这个数字没有魔法。上下文变长后,中间位置的信息更容易被忽略(引用 [2]),这也是块不能无限变大的原因之一。真正的约束是:一个块要能独立回答一个问题。如果答案必须跨两个块才能拼出来,说明块切小了;如果一个块里能问出三个不相关的问题,说明切大了。
三种切法,同一套向量
本书把切分实现成三种策略,参数与代码在 labs/05-rag/chunking.py:
| 策略 | 怎么切 | 适用 |
|---|---|---|
| 按长度 | 固定 400 字窗口,重叠 80 字,尽量落在句末 | 结构不明的纯文本 |
| 按结构 | 法规按“第 X 条”,文档按标题/段落;过长再按句切 | 法规、手册、有明确层级的文档 |
| 按语义 | 逐句向量,相邻相似度低于 0.55 就断开 | 话题跳跃、无标题的长文 |
结果如下(同一批 60 道非拒答题,稠密检索,实测,见 benchmarks/rag/chunking.csv):
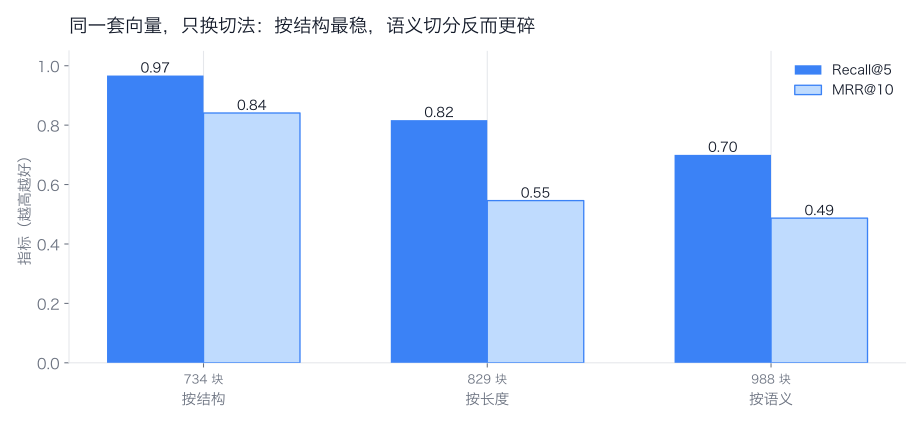
三个数字值得逐个说。
按结构切:734 块,Recall@5 = 0.967。 法规的“第 X 条”天然是一个语义单元,切完块与条款一一对应,出处也能落到条款号。这是本书的默认策略。
按长度切:829 块,Recall@5 = 0.817。 固定窗口便宜、通用,但会在句中、表格中间下刀;表格一旦被切断,表头归属就丢了,检索到那一行,模型也不知道它是什么。
按语义切:988 块,Recall@5 = 0.700。 这个结果反直觉:更“聪明”的切法反而更差。原因有两个: 一是句向量相似度在中文法规上并不稳定,条款内部的并列句会被误判成话题切换; 二是块被切得太碎(平均 141 字),一条条款散成两三块,任何一块都答不全。
(实测,见 benchmarks/rag/chunking.csv;相关性判定用块与标准条款的 4-gram 覆盖率,阈值 0.35,避免把“找到半条”一律判成失败。)
为什么“语义切分”经常名不副实
市面上的“语义切分”大致是:算相邻句子的 embedding 余弦,低于阈值就断开。它假设“话题变了,向量就像换了方向”。这个假设在两种情况下不成立:
- 同一话题内的并列句:法规里“应当……;应当……”句式,句子之间相似度未必高;
- 短句:一句话只有十几个字,向量本身噪声大,阈值附近随机抖动。
更稳的替代是做结构优先、语义兜底:有条款/标题就按结构切;没有结构的长文,再用语义边界,并且设一个最小块长(本书 60 字)和最大块长(800 字)。 语义切分不是免费午餐,它多了一次全量句向量的成本(本书 988 块花了 141 秒),却不一定换来召回。
表格:不切,是最省事的正确
表格的每一行都依赖表头。把表头和数据行分开,等于把 0.001 变成一个没有单位的数字。
本书的做法是:表格整块保留,标 type=table,不参与按句切分。代价是表格块可能超过 400 字;收益是数值问题还能答。
真实语料的 PDF 表格在解析阶段已经被摊平成文本,切分器看不出“这是表头”。 所以本书的实测无法用“丢表头行数”衡量真实表格,只能说明:表格不要参与按句切分,整块保留。 5.2 已经看到文本层表格的单元格问题(小数点错位、空单元格);切分救不回来,只能不切。
如果表格特别大(比如 30 列的排污表),整块保留会撑爆上下文。这时按行组切,并给每一块重复表头;不要只切数据行。
重叠要不要留
重叠(overlap)是为了防止答案正好落在切口上。它有用,但不是越大越好:
- 重叠 80 字,索引体积增加约 20%(400 字块);
- 重叠超过 50%,同一段内容会被多个块重复召回,去重逻辑变复杂。
本书固定 80 字。如果你的文档段落很长、句子很短,可以把重叠降到 40–50 字;如果表格多,优先保证表格不被切,而不是加大重叠。
工程含义
先看文档有没有结构,再决定切法。 法规、手册、说明书都有条款或标题;论坛帖、聊天记录没有。前者按结构,后者才轮到固定窗口或语义。
把“块”当成带元数据的检索单元,不是一段字符串。 块上要带 doc_id、page/clause、section、type;否则 5.8 没法标出处,5.9 没法做权限。
切分参数要跟 embedding 模型一起调。 换模型、换语言、换文档类型,最优块长都会变;本书的 400 字只对“中文 + Qwen3-Embedding + 这类法规/手册”负责。
语义切分先做小样本对照,再全量。 它贵,而且经常不划算;用 20–30 道题对比召回,比凭直觉选它可靠。
动手实验
动手实验:把块长从 400 扫到 800
假设:块长增大后,跨段题的召回先升后降;在本语料上,600 字可能是比 400 更好的点。
做法:改 labs/05-rag/config.yaml 的 chunk_size 为 300/400/600/800,删掉 labs/05-rag/.cache/chunks-structure.jsonl 与 vectors-1024.npy,重跑 chunking.py 与 retrieve.py。
记录:块数、平均长度、Recall@5、MRR@10、top-5 上下文的总 token 数。注意:每次只改一个参数;块长变了,5.7 的候选数与重排成本也会跟着变。
参考资料
- Karpukhin, V. et al. Dense Passage Retrieval for Open-Domain Question Answering(段落级检索与 100 词 passage 的训练设置,EMNLP 2020). https://arxiv.org/abs/2004.04906
- Liu, N. F. et al. Lost in the Middle: How Language Models Use Long Contexts(上下文越长,中间位置的信息越容易被忽略). https://arxiv.org/abs/2307.03172