

主题
量化原理:scale、zero-point 与分组量化
本章要回答的问题:scale 和 zero-point 是怎么把浮点压成整数的?分组量化又是在分什么组?
4.1 留下一个矛盾:int4 逐张量的误差是 20%–70%,明显不能用;但把权重每 32 个分成一组、每组单独配一个 scale,误差就掉到 10% 附近,模型又能说话了。这一节把这件事拆开:误差从哪来,分组为什么有用,以及 4 位为什么刚好是拐点。
一个公式,三个选择
把浮点 x 压成 b 位整数,只需要一个仿射变换(affine quantization):
q = clip(round(x / s) + z, 0, 2^b - 1)
x̂ = (q - z) × s
s 是缩放系数(scale),z 是零点(zero-point),clip 防止越界。公式只有一行,工程上的所有差异都来自三个选择:
- s 怎么算:用最大值、用分位数、还是用最小二乘拟合。
- z 要不要:
z = 0叫对称量化(symmetric),权重通常用它;z ≠ 0叫非对称量化(asymmetric),能把 [min, max] 平移到整数格点上,激活值常用。 - s 管多少个数:整个张量一个 s(per-tensor)、每个输出通道一个(per-channel)、还是每 32/64/128 个权重一个(分组,group-wise)。
第三个选择最影响质量,也最影响文件大小——因为每个 s 本身要占位。
误差从哪来
量化误差有两块,性质完全不同:
- 舍入误差:
x/s落在两个整数之间,四舍五入丢掉的小数。它的上界是s/2,在组内近似均匀分布,方差约为s²/12。 - 截断误差:
x超过[-qmax×s, qmax×s]时被clip硬切。对称量化按最大值定 s,理论上不会截断;但一旦有人改用分位数定 s,超出部分就全被切掉。
舍入误差和位宽是指数关系:每多一位,s 减半,量化步长与舍入误差也减半。所以 8 位到 4 位,步长差 16 倍;本地实测的 RMSE 差约 18 倍(表 4.1-1 的 int8 与 int4 逐张量两列),多出来的部分来自分布形状与块边界。
截断误差则是分布问题。权重近似以 0 为中心的钟形分布,绝大多数值落在 ±3σ 内,个别离群值能到 10σ 以上。一个全局 scale 会被离群值绑架:为了不截断那个 10σ 的值,s 被迫放大,99% 的正常权重就只剩几个整数格点可用。
本地这个模型上,逐输入通道的最大绝对值与中位数之比是这样的:
| 张量 | 通道数 | 最大 / 中位数 | 99 分位 / 中位数 |
|---|---|---|---|
ffn_down | 12288 | 3.9 | 1.7 |
attn_qkv | 4096 | 3.1 | 1.6 |
ffn_up | 4096 | 2.1 | 1.6 |
(实测,见 benchmarks/quantization/outliers.csv)
3.9 倍不算离谱,但它意味着:用全局 scale 时,一半以上的通道只能用上不到 1/4 的整数格点。分组量化的作用就是把"被绑架"的范围限制在组内——一个离群值只毁掉 32 个权重,不是 4096 个。
实测:分组多大才够
拿同一个 attn_qkv 张量,固定 4 位和 8 位,扫不同的分组大小,看归一化 RMSE 怎么变(图 4.2-1)。
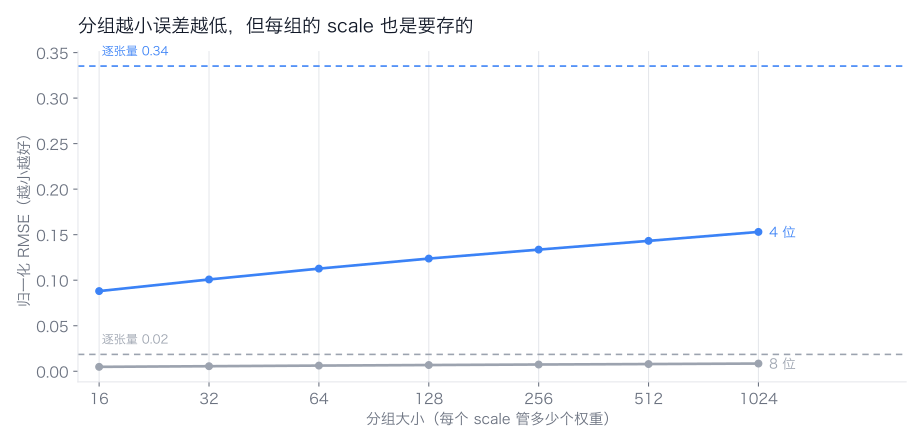
| 分组 | 4 位 对称 | 4 位 非对称 | 8 位 对称 |
|---|---|---|---|
| 16 | 0.088 | — | 0.0048 |
| 32 | 0.101 | 0.083 | 0.0055 |
| 128 | 0.124 | 0.105 | 0.0068 |
| 1024 | 0.153 | — | 0.0085 |
| 逐张量 | 0.335 | — | 0.0185 |
(实测,见 benchmarks/quantization/group-size.csv)
四个读数:
分组把误差砍掉 3 倍多。 4 位逐张量 0.335,32 个一组 0.101。这不是微调,是"能用/不能用"的分界。
曲线很快就平了。 从 16 放宽到 32,误差只涨 15%;从 32 放宽到 128,再涨 23%。再往下放宽收益越来越小,而 scale 开销线性下降,所以工程上停在 32–128 是合理的。
非对称在 4 位下明显更值。 同样 32 一组,非对称 0.083,比对称的 0.101 好 18%。原因是权重分布略偏,零点让整数格点对齐到实际区间;到 8 位时这点偏移被精度淹没,两者几乎没差(0.0049 对 0.0055)。
8 位几乎不吃分组的红利。 8 位逐张量 0.0185、32 一组 0.0055,也是 3.3 倍——但 8 位即使不分组的 1.85% 也已经够用。分组是低比特的救命手段,不是高比特的必需品。
算一下开销
分组不是免费的。设整数 b 位、每组 g 个权重、每组一个 fp16 scale:
实际位宽 = b + 16 / g- 4 位、g=32:4.5 位/权重
- 4 位、g=128:4.125 位/权重
- 4 位、g=32,scale 改用 6 位、再加 6 位 min:4 + 12/32 ≈ 4.38 位
Q4_K 走的是第三条路:它不存 fp16 scale,而是把 8 个子块的 6 位 scale 和 6 位 min 打包,再配两个 fp16 的超级块基准 d 和 dmin(图 4.3-1)。4 + 12/32 = 4.375 位,加上每 256 个权重两个 fp16 基准的 0.125 位,正好 4.5 位/权重——和"fp16 scale + 32 一组"打平,但精度更好,因为 min 让每个子块能自己平移。
这也解释了为什么文件名里的 Q4 不等于 4 位/权重:scale 的开销永远要摊回来。
工程含义
先问分组,再问位宽。 "4 位模型"这个说法没有信息量;Q4_0 是 32 个一组、fp16 scale、对称;Q4_K 是 256 超级块 + 32 子块、6 位 scale 与 min;IQ4_XS 又换了一套格点。三者都是 4 位,误差能差一倍。
别自己写量化器,除非你要调校准。 公式一行,但 s 的选法、离群值处理、分组边界对齐、SIMD kernel 都是坑。llama.cpp、GPTQ、AWQ 各自解决了其中一部分,选一个用,把精力放在测质量上。
误差可以算,质量不能推。 10% 的权重 RMSE 听起来很糟,但模型有冗余,最终掉多少分只能测(4.6 节)。反过来,RMSE 更小也不保证任务更好——这是所有量化论文都要跑下游任务的原因。
动手实验
动手实验:换一种 s 的选法,看误差怎么变
假设:用 99.9 分位代替最大值定 scale,能进一步降低 4 位误差,代价是引入少量截断。
命令(在 labs/04-quantization/inspect_tensors.py 里加一个 --clip-percentile 分支,然后):
bash
uv run labs/04-quantization/inspect_tensors.py --out benchmarks/quantization/clip-sweep记录:分组 32、4 位下,99.9 / 99.5 / 99 分位三种取法的 RMSE 与截断比例。预期:分位越低,舍入误差越小、截断误差越大,存在一个最优点;如果最优点落在 99.9 附近,说明"用最大值"已经接近最优,不值得改。
参考资料
- Jacob, B. et al. Quantization and Training of Neural Networks for Efficient Integer-Arithmetic-Only Inference(仿射量化的公式与零点,CVPR 2018). https://arxiv.org/abs/1712.05877
- Xiao, G. et al. SmoothQuant: Accurate and Efficient Post-Training Quantization for Large Language Models(激活离群通道与 per-channel scaling). https://arxiv.org/abs/2211.10438
- ggml 项目.
ggml-common.h(block_q4_K的d、dmin与 6 位 scale/min 布局). https://github.com/ggml-org/llama.cpp/blob/master/ggml/src/ggml-common.h - Dettmers, T., Zettlemoyer, L. The case for 4-bit precision: k-bit Inference Scaling Laws(4 位在总位数与精度上的经验拐点). https://arxiv.org/abs/2212.09720