

主题
稀疏检索与混合检索:BM25、RRF,以及工业场景为什么离不开关键词
本章要回答的问题:向量检索已经能按意思找了,为什么还要 BM25?混合检索一定比单路好吗?RRF 在融合什么?
向量检索擅长“换个说法也能找到”,但它有两个盲区:型号、编号、条款号、数字。这些 token 没有语义近邻,ZJ-03 和 ZJ-01 在向量空间里可能挨得很近,在业务上却是两台设备。
BM25 正好相反:它只认词,不认意思,但对精确 token 极其可靠。工业文档里到处是型号与编号,所以这一节不是“可选的优化”,而是链路的另一半。
BM25 在算什么
BM25 给“查询词出现在文档里”打分,两个因子:
- TF:词在文档里出现越多,分数越高,但增长会饱和(
k1控制饱和速度); - IDF:词在越多文档里出现,越不值钱(“的”“应当”几乎不加分);
- 长度归一化:长文档天然更容易命中,要按长度打折(
b控制打折力度)。
本书用 k1=1.5、b=0.75,中文分词用 jieba 的搜索模式,丢掉单字虚词。参数写在 config.yaml,没有针对测试集调过。
BM25 的优点是透明、可解释、零训练;缺点是词表不匹配就完全失效。用户问“液压油多久换”,文档写“润滑油更换周期”,BM25 一个词都对不上。
向量检索补的是哪块
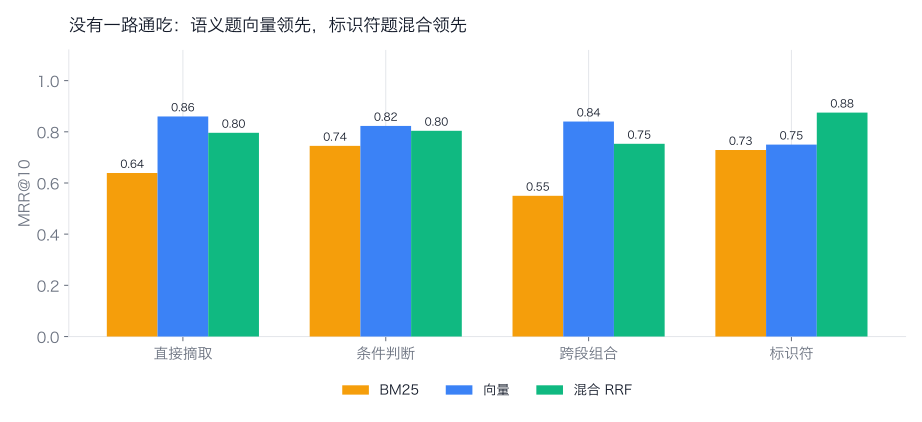
向量检索把查询和文档映射到同一个空间,近义词、改写、跨语言都能对上。上一节的 60 道题里,纯向量的 Recall@5 是 0.967,BM25 是 0.900(实测,见 benchmarks/rag/retrieval.csv)。
但把题按类型拆开,故事就变了。额外构造 8 道标识符查询(“北京市人民政府令第 285 号”“应急管理部令第 13 号”“DB44 标准”等):
| 题型 | 指标 | BM25 | 向量 | 混合 RRF |
|---|---|---|---|---|
| 60 道语义/条件/跨段题 | Recall@5 | 0.900 | 0.967 | 0.917 |
| 8 道标识符题 | Recall@5 | 0.875 | 0.875 | 0.875 |
| 8 道标识符题 | MRR@10 | 0.729 | 0.750 | 0.875 |
(实测,见 benchmarks/rag/retrieval.csv;734 块真实语料)
标识符题的召回三路打平,差别在排序:混合的 MRR 比单路高 0.13 左右。 语义题上混合比纯向量低 5 个百分点,说明两路等权融合并不总是加分。 “混合检索更好”这句话,取决于题型、语料和两路的强弱。
RRF:只比名次,不比分值
BM25 的分数是“词频加权”,向量相似度是“余弦”,两者量纲不同,不能直接相加。RRF(Reciprocal Rank Fusion)绕开这个问题:
score(d) = Σ_i 1 / (k + rank_i(d))k 通常取 60;排名越靠前,贡献越大;两路都靠前的文档得分最高。它不需要归一化,也不假设两路分数可比——这是它能跨检索器使用的根本原因(引用 [2])。
本书的实现很直接:两路各取 20 条,RRF 融合后保留 20 条,交给重排。rrf_k=60 没有调参。 在标识符题上,混合确实把 MRR 从 0.75 抬到了 0.875;在 60 道语义题上,它又不如纯向量。
为什么混合没有全面赢
三个原因,按重要性排:
第一,语料小。 734 块里,一个问题的正确答案往往只有一两条,向量的语义优势被放大,BM25 的精确匹配优势没有足够多的干扰项来体现。
第二,测试集以改写题为主。 80 题里 60 道是语义/条件/跨段题,只有 8 道标识符题;平均分自然偏向向量。真实工业场景里,型号与编号类问题占比可能远高于 8/68。
第三,RRF 对弱的一路没有降权。 BM25 在跨段题上只有 0.80,融合时仍然按同等名次贡献,拉低了向量本来能拿到的位置。工程上可以给两路加权(weighted RRF),但那就需要验证集来调权重,本书没有做。
这不是说混合检索没用。它说明:混合的收益是分题型、分语料、分权重的,必须按切片评估。
跨段题:为什么 joint recall 更难看
retrieval.csv 里还有一列 joint_recall@5:跨段题要求两个出处都进前 5。60 道题里 20 道是跨段题:
- 向量:0.80
- BM25:0.40
- 混合:0.45
(实测,见 benchmarks/rag/retrieval.csv;20 道跨段题)
跨段题的难点不是“找到一条”,而是“两条都找到”。BM25 对同义改写不敏感,经常只命中其中一条;RRF 把 BM25 的候选带进来,反而挤掉了向量找到的第二条。 如果业务里跨段问题多,应该单独优化这一列,而不是看总 Recall。
工程含义
按题型路由,比调一个总权重更有效。 查询里出现型号/编号/条款号,优先混合或提高 BM25 权重,不要退回纯 BM25(本书的标识符题上它并没有反超向量);纯自然语言问题,向量优先。
BM25 的中文分词要对业务词友好。 jieba 默认词典不认识 ZJ-03、M-2004 这类编号,需要加自定义词典或正则先切出编号,否则 BM25 的精确匹配优势会被分词毁掉。
混合不是免费的。 两路索引、两套更新、两倍存储;如果业务里几乎没有精确 token 查询,纯向量更简单。
评估必须分切片。 至少按“含标识符/不含标识符”“单段/跨段”分开报;只看总分,会做出错误的架构选择。
动手实验
动手实验:把 BM25 权重调上去,看两类题怎么变
假设:weighted RRF(BM25 权重 2、向量权重 1)能让标识符题的 MRR 保持在 0.85 以上,同时把跨段题的 joint recall 拉回 0.7 以上。
做法:改 labs/05-rag/retrieve.py 的融合函数,给两路排名乘权重;在 80 题上按 direct/condition/cross/identifier 四类分别报 Recall@5 与 joint recall。
记录:四类题的 Recall@5、joint recall、以及权重变化对 MRR 的影响。注意:权重是在这 80 题上选的,必须在另一批题上验证,否则只是过拟合。
参考资料
- Robertson, S., Zaragoza, H. The Probabilistic Relevance Framework: BM25 and Beyond(BM25 的推导与参数含义,2009). https://doi.org/10.1561/1500000019
- Cormack, G. V., Clarke, C. L. A., Buettcher, S. Reciprocal Rank Fusion outperforms Condorcet and individual Rank Learning Methods(RRF 原始论文,SIGIR 2009). https://doi.org/10.1145/1571941.1572114
- Thakur, N. et al. BEIR: A Heterogenous Benchmark for Zero-shot Evaluation of Information Retrieval Models(跨域检索评估与稀疏/稠密对比). https://arxiv.org/abs/2104.08663
- Luan, Y., Eisenstein, J., Toutanova, K., Collins, M. Sparse, Dense, and Attentional Representations for Text Retrieval(稀疏与稠密表示的理论联系,TACL 2021). https://arxiv.org/abs/2005.00181