

主题
重排:双塔模型与交叉编码器
本章要回答的问题:召回已经拿到候选,为什么还要再排一次?重排到底提升了什么,代价是什么?
召回和排序的目标不同。召回怕漏,所以宽松;排序怕错,所以严格。用一个模型同时做两件事,通常两头都不讨好。
重排(rerank)就是把这个分工显式化:双塔模型先粗筛 20–100 条,交叉编码器再逐对精读,只留下 5 条。
双塔与交叉编码器差在哪
双塔(bi-encoder):问题和文档分别编码成向量,再算余弦。文档向量可以离线算好、建索引,查询时只算一次;代价是问题和文档在编码时没有见过对方。
交叉编码器(cross-encoder):把“问题 + 文档”拼在一起送进模型,直接输出相关性分数。它能看见词与词之间的交互,判断更准;代价是每一对都要跑一次模型,不能预计算。
这也解释了为什么重排不能替代召回:如果正确答案不在候选里,重排再准也救不回来。候选数(本书 20)是召回率与延迟的折中。
实测:提升了召回,没提升第一名
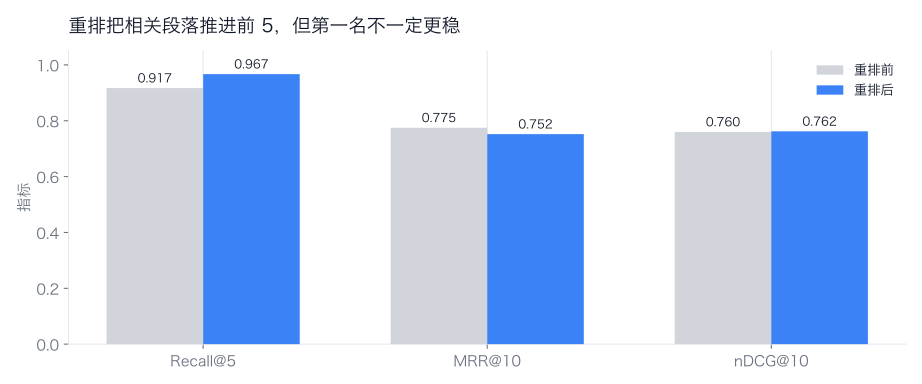
本书用 bge-reranker-v2-m3(Apache-2.0,Q8 GGUF),对混合检索的 top-20 逐对打分,取前 5:
| 阶段 | Recall@5 | MRR@10 | nDCG@10 | p50 |
|---|---|---|---|---|
| 重排前(RRF top-5) | 0.917 | 0.775 | 0.760 | — |
| 重排后 | 0.967 | 0.752 | 0.762 | 1044 ms |
(实测,见 benchmarks/rag/rerank.csv;60 道非拒答题,M4 24GB)
三件事值得说:
Recall@5 涨了 5 个百分点。 重排把原本排在第 6–20 位的相关段落推进了前 5,这正是它的价值。
MRR 反而略降。 60 道题里有 27 道的 top-1 换了人,其中一部分换错了。交叉编码器更擅长判断“相关不相关”,不总是更擅长判断“哪个最相关”;在小语料上,这种波动会被放大。
nDCG 只涨了 0.002。 排序质量整体变化很小——因为候选本身已经不错,重排能做的有限。
0.96 秒一次,贵不贵
20 条候选、每题一次重排,p50 是 1044 毫秒(实测,见 benchmarks/rag/rerank.csv)。这是 M4 上 568M 参数交叉编码器的成本。
放到线上,这个数字决定了三件事:
- 能不能接受:对话式问答的端到端预算如果是 3 秒,重排占 1 秒就很重;离线批处理则无所谓。
- 要不要批:
llama-server的 rerank 端点可以一次传多条文档,但延迟由最长的一条决定;并发上来后要限流。 - 候选数取多少:20 → 50 会把召回再抬一点,但延迟近似线性涨;先看 recall@20 是否已经够,再决定要不要扩大。
一个常见的折中:只对高价值查询重排。比如“涉及金额/条款/设备型号”的问题走重排,闲聊式问题直接返回召回结果。
模型怎么选
本书用的是 bge-reranker-v2-m3:多语言、568M、Apache-2.0,llama.cpp 直接支持 --reranking,输出原始 logits(可排序,不必归一化)。
选型时看三件事:
- 语言与领域:中文/多语言模型优先;通用模型在法规、工艺术语上会弱一些;
- 延迟:参数量与序列长度决定成本;说得再好,1 秒一次也未必能用;
- 许可:重排模型常被忽略,但它同样要能商用。
Qwen3-Reranker 系列也是可选路线(引用 [3]),但它是生成式判定(输出 yes/no 的概率),与分类头式交叉编码器的部署方式不同;llama.cpp 的 --reranking 端点主要面向后者。
工程含义
重排的输入必须是召回覆盖的候选。 先看 recall@20,再看 recall@5;如果 recall@20 只有 0.8,重排最多把 0.8 变成 0.8,变不出 1.0。
三项指标一起报。 只看 Recall 会误以为重排全面变好;只看 MRR 会误以为它有害。Recall 看“有没有进前 5”,MRR 看“第一名准不准”,nDCG 看整体排序。
延迟要算进端到端预算。 重排是串行的:召回 → 重排 → 生成,三段延迟相加。5.1 会看到,长上下文的首字延迟可以到几十秒;重排的 1 秒相比之下不算最大头,但也不能忽略。
分数不可跨模型比较。 重排输出的是 logits,不是概率;不同模型、不同批次的绝对值不可比,只能用于同一次查询内的排序。
动手实验
动手实验:候选数从 20 扫到 50
假设:候选数增加到 50 后,Recall@5 还能再涨 1–2 个百分点,但 p95 延迟翻倍。
做法:改 config.yaml 的 candidate_k 为 20/30/50,重跑 retrieve.py 与 rerank.py;记录 recall@k、MRR、nDCG、p50/p95。
记录:三项指标 + 延迟 + 每题平均候选 token 数。注意:候选数变化会改变 5.8 的提示词长度与生成成本,链路要整体重测。
参考资料
- Nogueira, R., Cho, K. Passage Re-ranking with BERT(交叉编码器做段落重排的原始工作). https://arxiv.org/abs/1901.04085
- Khattab, O., Zaharia, M. ColBERT: Efficient and Effective Passage Search via Contextualized Late Interaction over BERT(双塔与交互式表示的折中,SIGIR 2020). https://arxiv.org/abs/2004.12832
- Zhang, Y. et al. Qwen3 Embedding: Advancing Text Embedding and Reranking Through Foundation Models(含 Qwen3-Reranker 的训练与用法). https://arxiv.org/abs/2506.05176
- BAAI. bge-reranker-v2-m3 模型卡(多语言交叉编码器,Apache-2.0). https://huggingface.co/BAAI/bge-reranker-v2-m3