

主题
显存估算:一套通用公式和速查表
本章要回答的问题:给定模型大小和上下文长度,我能不能提前算出要占多少内存、会不会 OOM?
一张账单的五个部分
推理时的内存占用可以拆成五项,逐项估完再加总:
总占用 ≈ 权重 + KV Cache + 计算缓冲 + 运行时开销 + 安全余量权重:直接看 GGUF 文件大小,不要用"参数量 × 位数"反推。文件里除了量化后的权重,还有缩放系数、词表、元数据,反推会偏小。Qwen3.5-9B 的 Q4_K_M 是 5.68 GB(引用 [1]),Qwen3-14B 是 9.0 GB(引用 [2]),Gemma-4-26B-A4B 是 16.95 GB(引用 [3])。
KV Cache:用 1.4 节的公式,按 config.json 里的层数、KV 头数、头维度算,再乘上你设置的上下文长度。
计算缓冲:prefill 阶段的中间结果。它和批大小(-b/-ub)、隐藏维度有关,llama.cpp 在 ubatch 为 2048 时通常占几百 MB(估算)。调大 -ub 会明显增加这部分。
运行时开销:Metal 或 CUDA 上下文、引擎自身的预留、分词器和输出缓冲。桌面级通常在 0.5–2 GB(估算,引擎和平台差异较大)。vLLM 这类服务引擎会一次性预留 gpu_memory_utilization(默认 0.9)比例的显存,表现得比 llama.cpp 更"贪"。
安全余量:留 20% 左右(估算)。碎片、临时峰值、系统其他进程都会来抢。
三个模型的账本
按 f16 的 KV Cache 估算(Qwen3-14B:40 层 × 8 KV 头 × 128 维 × 2 × 2 字节 = 160 KiB/token)。下表统一用 GB(10⁹ 字节),与文件大小口径一致:
| 模型 | 权重 | KV(8K) | 计算与运行时开销 | 小计 | 含 20% 余量(估算) |
|---|---|---|---|---|---|
| Qwen3.5-9B | 5.68 GB | 0.27 GB | 1.5 GB | 7.45 GB | 约 8.9 GB |
| Qwen3-14B | 9.0 GB | 1.34 GB | 1.5 GB | 11.84 GB | 约 14.2 GB |
| Gemma-4-26B-A4B | 16.95 GB | 约 1 GB | 1.5 GB | 19.45 GB | 约 23.3 GB |
(KV 一列由每 token 字节数乘 8192 得到:9B 为 32 KiB × 8192 ≈ 0.27 GB;14B 为 160 KiB × 8192 ≈ 1.34 GB。计算与运行时开销取"计算缓冲 0.5 GB + 运行时开销 1 GB"两项之和。)
Qwen3.5-9B 每 token 只有 32 KiB,是因为 32 层里只有 8 层是全注意力(1.4 节)。Qwen3-14B 是标准结构,每 token 160 KiB,是前者的 5 倍。
Gemma-4-26B-A4B 的 KV 不能套一个公式:它的 30 层里大部分是滑动窗口注意力(窗口 1024),只有少数层是全注意力,而且全注意力层的头维度与局部层不同(引用 [4])。这类混合结构必须逐层算,粗略估计 8K 上下文下 KV 在 1 GB 量级(估算)。但它的权重就有 16.95 GB,留给 KV 的空间本来就少。
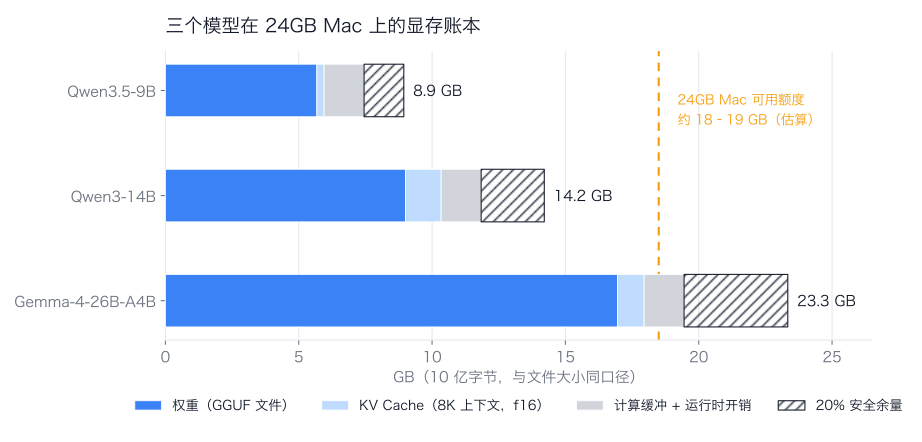
把三本账画在一起,差别一眼就能看出来(图 1.6-1):9B 的总占用只有 24GB 机器可用额度的一半,14B 还剩余量,26B-A4B 已经越线。
24GB 的 Mac 到底能放多少
关键不是 24GB,而是"24GB 减去系统和其他程序之后还剩多少"。
macOS 的统一内存被所有进程共享。浏览器、IDE、Docker 各占一块,系统本身也要几个 GB。经验上,一台正常使用的 24GB Mac,能给模型用的额度在 18–19 GB 左右(估算),超过这个数就开始用 swap。
swap 的可怕之处在于它不报错。模型确实"跑起来了",但每次读取权重都可能从 SSD 换入,生成速度可能掉到每秒一两个 token。看到这种断崖式下跌,先查内存,别调参数:
bash
vm_stat | head -8          # 看 Pageouts 是否在增长
memory_pressure            # 看系统内存压力百分比
对照上面的表,用"含 20% 余量"一列去比:
Qwen3.5-9B+ 8K 上下文约 8.9 GB,舒适;Qwen3-14B+ 8K 约 14.2 GB,可行;拉到 32K 约 19.0 GB,正好卡在可用额度边缘;Gemma-4-26B-A4B约 23.3 GB,已经超过可用额度,在 24GB Mac 上只能靠降上下文、关其他程序勉强运行,不适合作为日常配置。
这就是为什么本书把主力模型定为 9B:不是 14B 不好,而是在 24GB 的统一内存上,9B 能留出足够的空间给上下文、并发和系统,而 14B 和 26B-A4B 更适合放在 GPU 服务器上做对比。
不同引擎的估算方式不一样
llama.cpp 是"按需分配 + 显存不足时部分卸载",估算是"我需要多少"(引用 [6])。
vLLM 是"启动时预分配",逻辑反过来:它先看显存总量,乘以 gpu_memory_utilization(默认 0.9),减去权重,剩下的全部划给 KV Cache 池(引用 [5])。所以 vLLM 的 max_model_len 和 max_num_seqs 决定能开多少并发,而不是"剩余显存"。
TensorRT-LLM 又有自己的 workspace 概念。跨引擎搬数字之前,先确认两边的估算口径一致。 这也是第八部分验收时要固定引擎版本的原因之一。
一个可以抄的估算流程
- 查
config.json:层数、KV 头数、头维度、有没有混合注意力或滑动窗口。 - 算每 token 的 KV 字节数,乘上下文长度。
- 加上权重文件大小。
- 加计算缓冲(默认按 0.5 GB 估,
-ub调大就往上加)。 - 加运行时开销(桌面 1 GB,服务端按引擎文档)。
- 整体乘 1.2。
- 和可用内存比较:含余量的总额超过可用内存,就要降上下文、降量化或换模型。
这套流程不精确,但能在一分钟内判断"这个配置会不会炸"。精确的数字留给实测。
动手实验
动手实验:模型实测占用与公式的偏差
假设:峰值常驻内存与公式估算的偏差在 15% 以内;Gemma-4-26B-A4B 在 24GB Mac 上会触发 swap。
命令:
bash
# 主力模型必做。用 -n 128 而不是 -n 32,才能和正文引用的 tg128 对上
/usr/bin/time -l llama-bench -m "$MODEL" -p 512 -n 128 -r 1 -o md 2>&1 | \
  grep -E "maximum resident set size"
vm_stat | grep -E "Pageouts|Swapouts"

# 可选对照:两个更大的模型(需另行下载,24GB 机器上 26B-A4B 很可能触发 swap)
for m in Qwen3-14B-Q4_K_M.gguf Gemma-4-26B-A4B-Q4_K_M.gguf; do
  echo "== $m"
  /usr/bin/time -l llama-bench -m $m -p 512 -n 128 -r 1 -o md 2>&1 | \
    grep -E "maximum resident set size"
  vm_stat | grep -E "Pageouts|Swapouts"
done记录:每个模型的峰值常驻内存、Pageouts 增量、tg128 速度。同一次测量里,/usr/bin/time 包住的是模型加载与推理全过程,所以峰值包含权重、KV 和运行时开销,正好和公式的总额比,不要只和权重比。与公式估算并列成表,算出偏差。数据存 benchmarks/vram/,机型、macOS 版本、引擎版本写在同一份文件里。
参考资料
- Unsloth. Qwen3.5-9B-GGUF. https://huggingface.co/unsloth/Qwen3.5-9B-GGUF
- Qwen. Qwen3-14B-GGUF. https://huggingface.co/Qwen/Qwen3-14B-GGUF
- Unsloth. Gemma-4-26B-A4B-it-GGUF. https://huggingface.co/unsloth/gemma-4-26B-A4B-it-GGUF
- Google. Gemma-4-26B-A4B-it
config.json(sliding_window: 1024,global_head_dim: 512). https://huggingface.co/google/gemma-4-26B-A4B-it - vLLM Project. Conserve Memory / Engine Arguments. https://docs.vllm.ai/en/latest/configuration/engine_args.html
- ggml-org. llama.cpp(
-ub、-b、--flash-attn等参数说明). https://github.com/ggml-org/llama.cpp