

主题
向量库与 ANN 索引:HNSW 的直观理解
本章要回答的问题:向量检索为什么要建索引?HNSW 到底在图上做什么?什么时候它反而不划算?
上一节把文本变成了向量,检索就变成“在 N 个向量里找最接近的 k 个”。N 小的时候,挨个算一遍就完了;N 大了,暴力检索的延迟随 N 线性涨,索引才开始有意义。
这一节不接向量数据库,只用 hnswlib 在一台 Mac 上把机制跑出来。结论可能和你的预期相反:HNSW 不是无条件的加速器。
暴力检索什么时候够用
暴力检索(brute force)就是查询向量与每个块向量做一次点积,取前 k 个。它的复杂度是 O(N·d),但常数很小,而且对 CPU 缓存友好。
本书语料 734 块、1024 维,一次查询 0.041 毫秒(实测,见 benchmarks/rag/ann.csv)。这个量级下,任何索引的构建与维护成本都不值得。
把规模放大到 2 万条 1024 维随机向量,暴力检索一次 1.02 毫秒(实测)。仍然不快不慢,但已经能感觉到随 N 增长的压力。十万、百万级时,暴力检索才会变成瓶颈。
所以第一个工程判断不是“用哪个索引”,而是:你的 N 到底多大? 一万以下,先别急着上 ANN。
HNSW 在图上做什么
HNSW(Hierarchical Navigable Small World)把向量组织成一张多层近邻图:
- 每个点只连少量邻居(由
M控制); - 上层点少、边跨度大,用来快速靠近目标区域;
- 底层包含全部点,边更密,用来做精细搜索;
- 查询从上层入口开始,贪心地走向离查询更近的邻居,逐层下降。
三个参数决定它的行为:
| 参数 | 作用 | 变大的代价 |
|---|---|---|
M | 每个点的邻居数 | 图更大、构建更慢、查询略慢,但召回更稳 |
efConstruction | 建图时每层保留的候选数 | 构建更慢,图质量更好 |
efSearch | 查询时底层候选队列的宽度 | 查询更慢,召回更高 |
efSearch 是运行时参数,可以在“快”和“准”之间滑动;M 与 efConstruction 在建图时定死,改了就重建。
实测:真实语料与随机向量
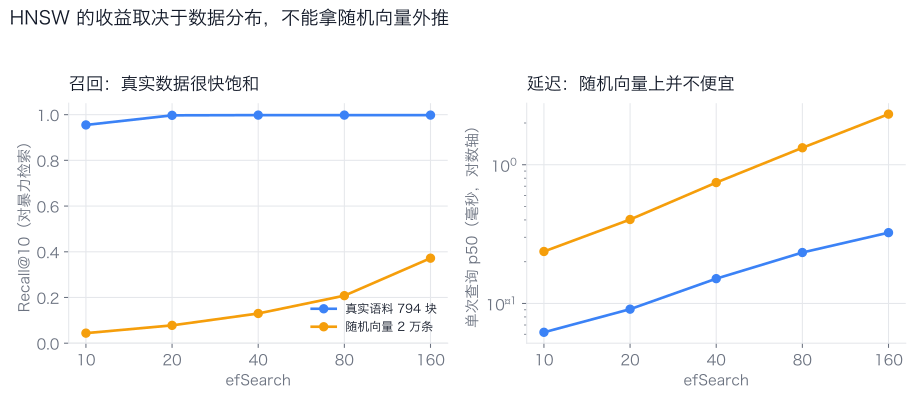
先看真实语料(734 块,1024 维):
| 方法 | efSearch | Recall@10 | p50 | p95 |
|---|---|---|---|---|
| 暴力 | — | 1.000 | 0.041 ms | 0.041 ms |
| HNSW | 10 | 0.955 | 0.062 ms | 0.080 ms |
| HNSW | 20 | 0.997 | 0.091 ms | 0.118 ms |
| HNSW | 40 | 0.998 | 0.151 ms | 0.186 ms |
| HNSW | 80 | 0.998 | 0.233 ms | 0.262 ms |
(实测,见 benchmarks/rag/ann.csv;M=16,efConstruction=200,seed=42)
在 734 个点上,HNSW 比暴力检索更慢。图遍历有固定开销,而暴力检索只要 0.041 毫秒。这就是“N 不够大时索引不划算”的具体样子。
再看 2 万条随机向量(同样是 1024 维):
| 方法 | efSearch | Recall@10 | p50 |
|---|---|---|---|
| 暴力 | — | 1.000 | 1.022 ms |
| HNSW | 10 | 0.044 | 0.237 ms |
| HNSW | 40 | 0.130 | 0.744 ms |
| HNSW | 160 | 0.372 | 2.316 ms |
(实测,见 benchmarks/rag/ann.csv;随机向量,seed=42)
这组数字的教训不是“HNSW 很差”,而是:随机 1024 维向量是 ANN 的最坏情况。 高维空间里点与点几乎等距,近邻图没有“更近的方向”可走,只有把候选队列开得很大才能勉强找回;开到 160,延迟已经超过暴力检索。
真实 embedding 不是随机分布:它们集中在低维流形上,有明确的簇结构,HNSW 才能发挥作用。这也是为什么 ANN-Benchmarks 要用真实数据集而不是随机向量(引用 [2])。
内存与构建成本
HNSW 的图本身也占内存。粗略估算:
向量:N × d × 4 字节(float32)
图:  N × M × 2 × 4 字节(每层最多 2M 条有向边)
2 万条 1024 维向量:向量约 82 MB,图约 2.6 MB(M=16),实测索引文件 84.5 MB。 构建 2 万条用了 11.4 秒(实测,单线程建图,M4);百万级要按分钟到小时算(估算,按线性外推),通常需要并行建图或离线预构建。
本书没有在真实语料上跑到 2 万——真实语料只有 734 块,扩语料会引入合成数据(见 corpus/GAPS.md)。 这张随机向量的图只回答“参数怎么影响延迟与召回”,不回答“真实语料上能省多少”。
过滤、删除与更新
HNSW 是图,不是表。它的三个工程约束在 5.9 会反复出现:
- 按元数据过滤:先在图上搜、再按权限删结果,会浪费候选名额;正确做法是只让可见的点参与搜索,或者用支持过滤的索引;
- 删除:
hnswlib用mark_deleted打标记,图结构不立即收缩,删多了要重建(引用 [3]); - 更新:改一个向量通常是“标记旧的 + 插入新的”,图会逐渐变胖,需要定期 compaction。
这些不是 hnswlib 的缺陷,而是图索引的共性。选向量库时,过滤与更新的支持程度比“标称 QPS”更影响长期维护。
工程含义
先量 N,再选索引。 一万以下,暴力检索加 numpy 就够;十万以上再考虑 HNSW/IVF;百万级要同时考虑内存、构建时间和过滤。
在自己的数据上扫 efSearch。 同一组参数,真实语料与随机向量的表现能差一个数量级;不要抄别人的曲线。
把召回当一等指标。 只报延迟不报召回,等于把“查得少”当成“查得快”。ANN 的延迟必须与 Recall@k 一起报。
过滤要前置。 后过滤会先浪费 top-k 名额,再删掉不可见的点,最终结果可能只剩两三条;5.9 会给出实测。
动手实验
动手实验:在 2 万条真实向量上重做这张表
假设:真实 embedding 在 2 万条时,HNSW 在 Recall@10 ≥ 0.95 的前提下能把 p95 压到暴力检索的 1/3 以下。
做法:把语料扩到 2 万块并向量化,复用 index_demo.py,把 run_dataset("real", ...) 换成 2 万条真实向量;M 扫 8/16/32,efSearch 扫 10–320。
记录:Recall@10、p50/p95、构建时间、索引文件大小。注意:合成语料的向量分布与真实文档不同,结论只能用于容量规划,不能用于检索质量。
参考资料
- Malkov, Y. A., Yashunin, D. A. Efficient and robust approximate nearest neighbor search using Hierarchical Navigable Small World graphs(HNSW 原始论文,TPAMI 2020). https://arxiv.org/abs/1603.09320
- Aumüller, M., Bernhardsson, E., Faithfull, A. ANN-Benchmarks: A Benchmarking Tool for Approximate Nearest Neighbor Algorithms(真实数据集上的 ANN 对比方法与参数敏感性). https://arxiv.org/abs/1807.05614
- hnswlib 项目. README:mark_deleted 与更新语义. https://github.com/nmslib/hnswlib